Przykładowy wstęp do pracy licencjackiej – PDF i gotowy wzór
4 września 2026
Wstęp do pracy inżynierskiej – poradnik krok po kroku
19 września 2026
Pytanie o to, jak działa antyplagiat, pojawia się zwykle w najbardziej nerwowym momencie studiów – kilka dni przed oddaniem pracy dyplomowej. Problem badawczy, który warto sobie wtedy postawić, brzmi jednak inaczej niż potoczne „ile procent mi wyjdzie”. Chodzi o to, na jakiej zasadzie oprogramowanie rozpoznaje zapożyczenie, jakie zbiory danych stanowią punkt odniesienia i gdzie przebiega granica między automatycznym pomiarem podobieństwa a ludzką oceną rzetelności tekstu. Literatura przedmiotu oraz dokumentacja techniczna systemów wskazują jednoznacznie: raport antyplagiatowy nie jest wyrokiem, lecz materiałem diagnostycznym, który wymaga interpretacji. Poniżej rozkładam ten mechanizm na czynniki pierwsze – od momentu wgrania pliku, przez segmentację tekstu, aż po decyzję promotora.
Czym właściwie jest system antyplagiatowy i po co uczelni taka kontrola
System antyplagiatowy to oprogramowanie porównujące treść badanego dokumentu ze zbiorami tekstów referencyjnych i raportujące fragmenty wykazujące podobieństwo. Warto od razu rozdzielić dwa pojęcia, które w rozmowach studenckich zlewają się w jedno. Jak wskazuje plagiat – definicja encyklopedyczna, jest to pojęcie z zakresu prawa autorskiego oznaczające skopiowanie cudzego utworu lub jego części wraz z przypisaniem sobie prawa do autorstwa poprzez ukrycie pochodzenia splagiatowanego dzieła. Program natomiast nie ocenia intencji ani autorstwa – mierzy wyłącznie stopień zbieżności ciągów znaków.
W Polsce od 2019 roku funkcjonuje rozwiązanie centralne. Stosowany jest jeden wspólny system – JSA (Jednolity System Antyplagiatowy) – który przeszukuje nie tylko internet, ale też bazę ORPPD, czyli Ogólnopolskie Repozytorium Pisemnych Prac Dyplomowych. Kontrola nie jest opcją do wyboru: Jednolity System Antyplagiatowy to obowiązkowe narzędzie, przez które przechodzi każda praca dyplomowa w Polsce. Mechanizm ma więc funkcję prewencyjną i dowodową jednocześnie – dokumentuje, że uczelnia dopełniła obowiązku weryfikacji przed dopuszczeniem studenta do obrony. Szerzej opisaliśmy to zagadnienie w tekście o tym, czym jest JSA antyplagiat i Jednolity System Antyplagiatowy w codziennej praktyce dziekanatów.
Z czym system porównuje tekst pracy dyplomowej
Skuteczność detekcji zależy nie od samego algorytmu, lecz od zasobu, z którym zestawiany jest dokument. Tu tkwi przewaga rozwiązania centralnego nad komercyjnymi testerami online. Według informacji resortu źródła referencyjne, z którymi JSA porównuje prace dyplomowe, są bardzo rozbudowane i obejmują m.in. wyszukiwarkę BING, korpus polskojęzycznych zasobów internetowych NEKST liczący ponad 2 mld stron, dziesięć najpopularniejszych w UE wersji językowych Wikipedii, publikacje otwartego dostępu w liczbie ponad 3 milionów dokumentów oraz bazy aktów prawnych i orzeczeń. Kluczowy jest jednak zasób niedostępny dla nikogo innego: szczególnie cennym źródłem jest ORPPD, do którego JSA ma dostęp jako jedyny system antyplagiatowy; baza zawiera wszystkie prace dyplomowe obronione w Polsce po 30 września 2009 roku i liczy blisko 4 miliony prac.
Ta asymetria zasobów tłumaczy zjawisko, które regularnie zaskakuje dyplomantów. Systemy komercyjne nie mają dostępu do bazy obronionych prac i porównują tekst wyłącznie z zasobami internetowymi, a jako plagiat wykrywają zwykle ciąg identycznych słów o określonej długości. Efekt bywa przykry: istnieje duże prawdopodobieństwo, że taki program nie wykryje zapożyczenia, a po weryfikacji w JSA współczynnik PRP okaże się bardzo wysoki. Wniosek metodologiczny jest prosty – wynik z darmowego narzędzia ma wartość orientacyjną, nie prognostyczną.
Bazy uczelniane i wykluczenia
Do zestawu źródeł dochodzą lokalne repozytoria instytucjonalne. Referencyjne bazy porównawcze to repozytoria, z którymi porównywana jest treść badanej w systemie pracy. Uczelnia może dołożyć własny zbiór prac zaliczeniowych, projektów czy raportów, co bywa istotne na kierunkach, gdzie studenci korzystają z tych samych danych źródłowych.
Algorytm dopasowania – od podziału tekstu na n-gramy do procentu
Sercem mechanizmu jest segmentacja. System antyplagiatowy opiera się na algorytmach porównujących ciągi znaków: dzielą one analizowany tekst na niewielkie fragmenty, czyli frazy, które następnie porównywane są z treścią innych publikacji. W nomenklaturze przetwarzania języka naturalnego takie fragmenty nazywa się n-gramami – ciągami n następujących po sobie wyrazów. Programy antyplagiatowe porównują tekst z bazami danych za pomocą algorytmów n-gramowych, a współczesne oprogramowanie nie szuka wyłącznie identycznych zdań – algorytmy radzą sobie także z wykrywaniem przestawionych słów i prostych synonimów.
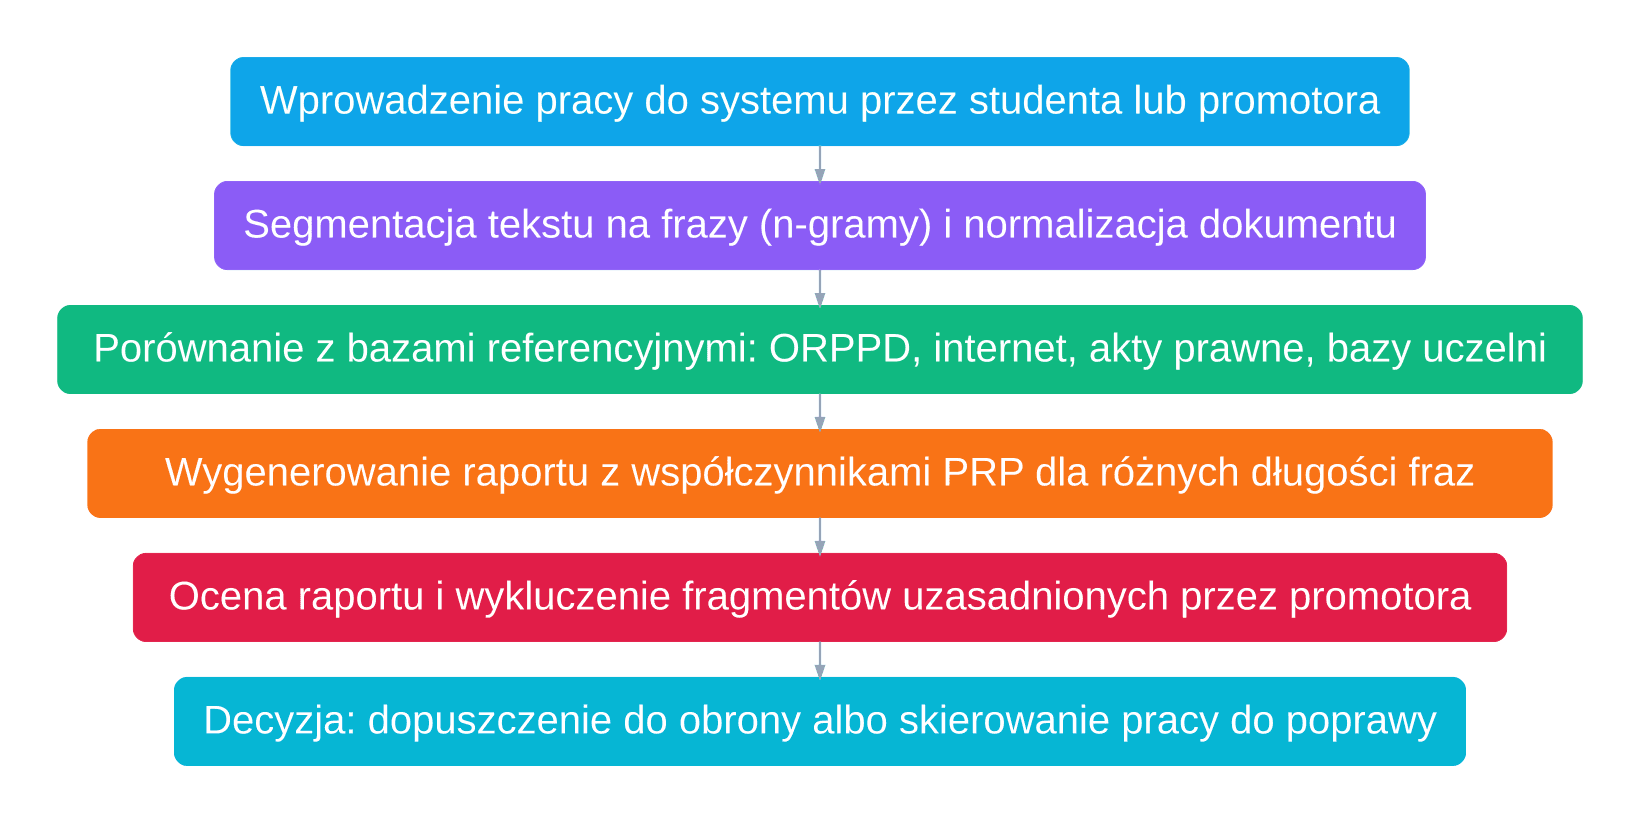
Procedura badania przebiega w powtarzalnej sekwencji. Najpierw następuje wprowadzenie pracy do systemu przez studenta lub promotora, potem analiza przez algorytm, który porównuje treść z repozytorium prac dyplomowych i innymi bazami referencyjnymi, następnie wygenerowanie szczegółowego raportu podobieństwa ze wskazaniem współczynników PRP, a na końcu ocena raportu przez promotora, który decyduje o dopuszczeniu pracy do obrony lub konieczności poprawek. Etap trzeci trwa zwykle kilkanaście minut do kilku godzin, w zależności od obciążenia serwera i objętości dokumentu.
Czułość detekcji jest parametrem, nie stałą
Rzecz, o której studenci wiedzą najmniej, a która ma największy wpływ na wynik: próg wrażliwości ustawia człowiek. Administrator systemu może wybrać jeden z czterech poziomów podobieństwa: niski – zalecany przez twórców, pozwalający wykryć nawet dobrze sparafrazowane teksty; średni – wykrywający zabiegi stylistyczne takie jak zmiana szyku zdań; wysoki – uznający za plagiat fragmenty wyraźnie podobne do oryginału; oraz bardzo wysoki, przy którym klasyfikowane są dosłownie skopiowane treści. Do tego dochodzą inne ustawienia konfiguracyjne: dopuszczalny próg PRP oraz dodanie wykluczeń tekstu, na przykład formuł, definicji czy teorii.
Konsekwencja praktyczna bywa dla studentów frustrująca, ale ma uzasadnienie merytoryczne. Jeżeli wynik wyniósł 30 procent, praca może zostać odrzucona, podczas gdy praca z 40 procentami na innym kierunku przejdzie weryfikację – podobieństwo semantyczne w pracach inżynieryjnych, ekonomicznych czy prawnych będzie zawsze stosunkowo wysokie, w przeciwieństwie do prac z socjologii czy filologii.
Stylometria, czyli analiza „odcisku palca” autora
Poza porównaniem frazowym system prowadzi analizę statystyczną języka. Rozkład długości wyrazów przedstawiony jest na wykresie pokazującym parametry pracy badanej na tle uśrednionych wartości ze wszystkich prac w bazie ORPPD, a wykres ten służy do oceny, czy była podjęta próba manipulacji tekstem związana z długością wyrazów. To odpowiedź na starą sztuczkę z podmienianiem liter na znaki z innego alfabetu lub wstawianiem białych znaków wewnątrz wyrazów. Anomalie stylometryczne nie dowodzą plagiatu, ale są sygnałem ostrzegawczym dla recenzenta.
Jak czytać raport podobieństwa i co oznaczają wskaźniki PRP
Raport bywa mylnie traktowany jak jedna liczba. To nie jest pojedyncza „ocena plagiatu”, lecz zestaw kilku współczynników i list, które trzeba interpretować łącznie. Podstawowym parametrem jest PRP: Procentowy Rozmiar Podobieństwa, czyli parametr wskazujący na poziom podobieństwa pracy badanej do innych prac z ORPPD i dokumentów pochodzących z innych źródeł porównania – internetu, aktów prawnych, uczelnianych baz referencyjnych – wyrażony w procentach.
Istotne jest to, że wskaźnik nie występuje pojedynczo. Wynik ogólny zawiera wskaźnik PRP obliczany dla różnych długości fraz podobnych – 5, 10, 20, 40 i więcej wyrazów we frazie. Interpretacja jest tu w miarę intuicyjna:
- PRP dla fraz krótkich (5 wyrazów) – zwykle najwyższy, obejmuje zwroty typowe dla języka naukowego, terminologię branżową, nazwy instytucji. Sam w sobie rzadko świadczy o nierzetelności.
- PRP dla fraz średnich (10–20 wyrazów) – tu zaczyna się strefa uwagi; długie zbieżne sekwencje sugerują przepisywanie lub bardzo płytką parafrazę.
- PRP dla fraz długich (25–40+ wyrazów) – wartość istotnie różna od zera przy takiej długości frazy oznacza niemal na pewno fragment przeniesiony bez przetworzenia.
Raport pokazuje też pochodzenie zbieżności. Wynik szczegółowy prezentuje podział współczynników ze względu na źródła pochodzenia podobieństw: ORPPD, internet, bazę aktów prawnych i bazę uczelni. Rozróżnienie ma znaczenie – 15 procent pochodzące z ustaw w pracy z prawa administracyjnego to co innego niż 15 procent pochodzące z jednej pracy magisterskiej obronionej trzy lata temu na sąsiednim wydziale.
Parafraza, synonimy i tłumaczenie – gdzie kończy się skuteczność detekcji
Najczęściej powtarzany mit brzmi: wystarczy pozamieniać słowa. Badania nad techniką parafrazowania konsekwentnie temu przeczą. Parafraza nie polega jedynie na zmianie szyku wyrazów w zdaniu; taka powierzchowna ingerencja w tekst źródłowy zdecydowanie nie jest wystarczająca, aby uniknąć plagiatu. Systemowo rzecz ujmując – przy poziomie czułości „niski” algorytm rozpoznaje właśnie takie zabiegi, ponieważ zachowany zostaje szkielet składniowy i sekwencja pojęć.
Jest jednak głębszy problem, którego żaden algorytm nie rozstrzygnie. Analizy poświęcone etyce pisania akademickiego wskazują, że przedstawienie cudzego pomysłu, teorii lub danych jako własnych pozostaje plagiatem nawet wtedy, gdy ubierzemy je we własne słowa, o ile nie wskażemy pochodzenia koncepcji. Ten wymiar wykrywa wyłącznie recenzent czytający pracę merytorycznie – system zaraportuje 8 procent i formalnie wszystko będzie w porządku.
Z tłumaczeniami sytuacja jest pośrednia. JSA porównuje tekst z wielojęzycznymi zasobami, w tym z kilkunastoma wersjami językowymi encyklopedii, więc dosłowne przełożenie popularnego opracowania obcojęzycznego bywa wykrywane. Nie ma jednak gwarancji, że detekcja zadziała przy każdym źródle. Praktyczny wniosek: strategia opierania rozdziału teoretycznego na maszynowym tłumaczeniu cudzego artykułu jest ryzykowna nie tyle z powodu procentów, ile dlatego, że taki tekst zwykle rozjeżdża się stylistycznie z resztą pracy – i to zauważa promotor, nie program. Jak solidnie zbudować aparat odsyłaczy, wyjaśniamy w tekście o tym, jak ułożyć bibliografię w pracy dyplomowej.
Fałszywe alarmy
Nie każdy podświetlony fragment to zapożyczenie. Systemy pokazują czasem fałszywe ostrzeżenia, co wynika zazwyczaj ze stosowania stałych związków frazeologicznych lub cytowania przepisów prawnych; wtedy ostateczną decyzję podejmuje promotor lub redaktor. Do typowych źródeł „szumu” należą: strona tytułowa i spis treści, bibliografia, standardowe formuły metodologiczne, nazwy aktów prawnych, opisy narzędzi psychometrycznych oraz cytaty prawidłowo oznaczone cudzysłowem.
Co dzieje się po przekroczeniu progu podobieństwa
Wbrew obiegowej opinii przekroczenie progu nie uruchamia automatycznie procedury dyscyplinarnej. Interpretacja raportu JSA należy do promotora – system wskazuje jedynie podobieństwa, a to promotor decyduje, czy dane zapożyczenia są uzasadnione, na przykład cytaty czy fragmenty aktów prawnych, i czy praca spełnia wymogi oryginalności. Ma przy tym narzędzie korygujące: może wykluczyć fragmenty, na przykład bibliografię, z raportu i ponownie przeliczyć wynik.
Typowa ścieżka postępowania wygląda następująco:
- Analiza raportu przez promotora – ocena, czy zbieżności są rozproszone i uzasadnione, czy skupione w kilku długich blokach.
- Wykluczenie fragmentów nieistotnych i ponowne przeliczenie wskaźników.
- Zwrot pracy do poprawy – gdy zbieżności są realne, student przeredagowuje wskazane akapity, uzupełnia przypisy lub zamienia płytką parafrazę na oznaczony cytat.
- Powtórne badanie w systemie i weryfikacja, czy poprawki przyniosły efekt.
- Skierowanie sprawy do komisji dyscyplinarnej – rozwiązanie stosowane wyjątkowo, przy przejęciu obszernych partii cudzego tekstu.
Otrzymanie raportu z wysokim wskaźnikiem podobieństwa bywa stresujące, lecz to sygnał, że praca wymaga dodatkowej uwagi – kluczem jest metodyczne i spokojne podejście do analizy oraz poprawy tekstu. Warto pamiętać, że konsekwencje realnego plagiatu są jednak dotkliwe. Opracowania etyczne wymieniają w tym kontekście niezaliczenie pracy lub kursu, postępowanie dyscyplinarne, odebranie stopnia naukowego, utratę reputacji, a w niektórych przypadkach odpowiedzialność prawną z tytułu naruszenia praw autorskich.
Najczęstsze pytania o mechanizm kontroli antyplagiatowej
Na jakiej zasadzie system porównuje tekst z bazami danych?
Dokument jest normalizowany (usuwane jest formatowanie, ujednolicana interpunkcja), następnie dzielony na nakładające się sekwencje wyrazów. Każda sekwencja otrzymuje wartość skrótu, którą system zestawia z indeksem zasobów referencyjnych. Dopasowania są łączone w dłuższe bloki i prezentowane w raporcie z odesłaniem do źródła. To dlatego wynik obliczany jest osobno dla fraz o różnej długości – im dłuższa zgodna sekwencja, tym mniejsze prawdopodobieństwo przypadku.
Co dokładnie oznaczają współczynniki PRP 1 i PRP 2?
To warianty tego samego wskaźnika liczone dla różnej minimalnej długości wykrytej frazy. PRP to zestaw osobnych wskaźników, z których każdy odnosi się do innej długości wykrytej frazy lub innego źródła. Pierwszy współczynnik obejmuje frazy krótkie i naturalnie przyjmuje wyższe wartości; drugi dotyczy fraz dłuższych i jest znacznie bardziej diagnostyczny. Praca z PRP 1 na poziomie 25 procent i PRP 2 poniżej 5 procent zwykle nie budzi zastrzeżeń. Odwrotna proporcja praktycznie nie występuje – a jeśli drugi wskaźnik rośnie, to sygnał realnego problemu.
Czy antyplagiat wykrywa parafrazę i tekst tłumaczony?
Przy najniższym progu czułości – w znacznej mierze tak, ponieważ system rozpoznaje zmianę szyku i podmianę synonimów. Głęboka parafraza, w której zmienia się struktura argumentacji i punkt wyjścia, jest dla algorytmu trudna do uchwycenia. Nie oznacza to jednak bezkarności: nieoznaczone przejęcie cudzej koncepcji pozostaje naruszeniem rzetelności niezależnie od wyniku procentowego.
Ile procent podobieństwa oznacza odrzucenie pracy?
Nie istnieje jeden ogólnopolski próg – ustala go uczelnia w regulaminie. Orientacyjnie przyjmuje się, że wynik powyżej 40 procent PRP oznacza zwykle, że praca nie może zostać zaakceptowana bez szczegółowej analizy i korekty. Trzeba jednak podkreślić to, o czym mówią specjaliści od analizy danych: wysoki wynik PRP w systemie JSA nie jest wyrokiem świadczącym o plagiacie. Decyduje struktura zapożyczeń, nie sama liczba.
Czy warto sprawdzić pracę wcześniej we własnym zakresie?
Tak, choć z pełną świadomością ograniczeń. Testy komercyjne operują na węższym zasobie i innym algorytmie, więc ich wynik nie przewiduje rezultatu JSA. Sensowniejszą profilaktyką jest metodyczna praca warsztatowa: rzetelne notowanie źródeł na etapie zbierania literatury, konsekwentne stosowanie przypisów i pisanie parafraz „z głowy”, bez otwartego oryginału przed oczami.
Praktyczne wnioski dla dyplomanta
Zrozumienie, jak działa antyplagiat, zmienia perspektywę: zamiast walczyć z procentami, warto projektować tekst tak, by wysokie zbieżności po prostu nie powstawały. Trzy zasady mają największą siłę oddziaływania. Po pierwsze – każdy akapit oparty na literaturze powinien kończyć się przypisem, nawet jeśli nie zawiera cytatu dosłownego. Po drugie – dosłowne fragmenty należy oznaczać cudzysłowem, ponieważ prawidłowo sformatowany cytat promotor bez trudu wyklucza z analizy. Po trzecie – w każdej sekcji teoretycznej powinno znaleźć się własne zdanie syntetyzujące lub porównawcze; to ono odróżnia opracowanie od kompilacji.
Systemy antyplagiatowe nie mierzą wartości naukowej pracy ani wysiłku włożonego w badania. Mierzą powtarzalność sekwencji językowych – i tyle. Cała reszta, czyli ocena, czy zapożyczenie jest uczciwe, uzasadnione i właściwie oznaczone, pozostaje w rękach człowieka. To dobra wiadomość dla każdego, kto pisze samodzielnie, i zła dla tych, którzy liczą na przechytrzenie algorytmu.